Um Material für einen sprechenden Dialektatlas wie diesen zu sammeln, ist es entscheidend, geeignete Aufnahmeorte und Sprecher*innen (sogenannte Gewährspersonen) zu finden. Da wir bodenständige Dialekte (Basisdialekte) aufnehmen wollten, legten wir bestimmte Kriterien fest: Die Aufnahmeorte sollten klein sein und nicht mehr als 2.500 Einwohner*innen haben, möglichst abseits von Hauptverkehrsrouten wie Bahnstrecken oder Autobahnen sowie großen Städten liegen und sich dazu möglichst gleichmäßig über Österreich verteilen. Die Sprecher*innen sollten im oder nahe des jeweiligen Aufnahmeort aufgewachsen sein, idealerweise auch ihre Eltern, den Großteil ihres Lebens dort verbracht haben und bevorzugt in landwirtschaftlichen oder handwerklichen Berufen tätig sein.
Um den Sprachgebrauch älterer Sprecher:innen mit dem jüngeren zu vergleichen und so indirekt Sprachwandel feststellen zu können, haben wir in jedem Ort ein bzw. zwei Personen gesucht, die über 60 Jahre alt waren, sowie ein bzw. zwei Personen zwischen 20 und 35 Jahren. Tatsächlich gefunden haben wir Sprecher*innen ab 58 Jahren (durchschnittlich 72 Jahre) sowie zwischen 18 und 38 Jahren (durchschnittlich 26 Jahre). Der Abstand zwischen dem Durschnittsalter beider Gruppen an einem Ort betrug zwischen 25 und 70 Jahre (durchschnittlich 45 Jahre), also in etwa 1 bis 2 Generationen.
In einer ersten Phase haben wir an 40 gleichmäßig über Österreich verteilten Orten je eine Sprecherin und einen Sprecher pro Altersgruppe, also vier Sprecher*innen insgesamt, aufgenommen. Später sind wir dazu übergegangen, nur noch eine*n Sprecher*in, egal welchen Geschlechts, pro Altersgruppe und Ort zu befragen, wodurch wir bei gleichem Arbeitspensum mehr Orte (insgesamt 67) abdecken und das Ortsnetz verdichten konnten. In dieser zweiten Phase haben wir 50 Sprecherinnen (26 ältere und 24 jüngere) sowie 84 Sprecher (41 ältere und 43 jüngere) erhoben. Männliche Gewährspersonen machen damit etwa 63 % der Befragten dieser Phase aus.
Sprache setzt sich aus mehreren aufeinander aufbauenden Ebenen zusammen: Lauten, Wortformen, Wortschatz und Satzbau. Mit unseren Fragen wollten wir möglichst alle diese Ebenen abdecken und innerhalb jeder Ebene möglichst alle bekannten Unterschiede erfassen. Das Ergebnis war ein Fragebuch mit insgesamt über 500 Fragen und noch mehr Unterfragen. Wir stellten die Fragen in verschiedenen Formen: als Übersetzung (z. B. Frage 525: Wie sagt man hier Die Katze, die da liegt, hat keine Angst vor unserem Hund?), als Vervollständigung (z. B. Frage 14: Wenn es rutschig ist, ist es …? Antworten: häl, hale, haö etc.), als Bildbenennung (z. B. Frage 277: Was sieht man hier? [zeigt das Bild einer Kartoffel]) oder als Erklärung (z. B. Frage 12: Was ist eine Nudel? Antworten: ein bestimmtes Schmalzgebäck aus Hefeteig, eine in Wasser zu kochende Teigware etc.). Die Befragungen dauerten zwischen zwei und vier Stunden und verlangten den Sprecher*innen einiges ab.
Wir haben die Sprecher*innen „im Feld“, also zuhause oder im nahen Umfeld besucht. Für die Befragung wählten wir einen ruhigen Ort wie Küche oder Stube und achteten darauf, dass keine störende Geräusche wie tickendende Uhren, surrende Kühlschränke, laufende Waschmaschinen oder bellende Hunde aufgenommen wurden. Den Sprecher:innen gegenübersitzend, zeichneten wir ihre Antworten mit Mikrofon und Aufnahmegerät digital auf. Die Befragung in der vertrauten Umgebung hatte zwei Vorteile: Sie lieferten möglichst authentisches Material, und die Sprecher:innen mussten nicht zur Universität anreisen, wodurch wir mehr Menschen für eine Teilnahme gewinnen konnten. Nicht in einem Labor aufzunehmen, hatte jedoch auch einen Nachteil: Die Tonqualität ist nicht immer optimal, und manche unvorhergesehene Störgeräusche ließen sich nicht vermeiden.
Da jede Sprache eine Vielzahl an möglichen Phänomenen aufweist, mussten wir eine Auswahl der Themen treffen sowie der Wörter und Sätze , anhand derer wir sie darstellen (d. h. Karten). Dabei haben wir uns an folgenden Kriterien orientiert: Zeigen sie die Unterschiede zwischen den großen Dialekträumen in Österreich, also zwischen dem Alemannischen im äußersten Westen und dem Bairischen im Rest des Landes (z. B. die Aussprache von A und Ä in machen und Käse) sowie innerhalb des Bairischen zwischen dem Mittelbairischen an der Donau und dem Südbairischen in den Alpen (z. B. die Aussprache von E in Schnee)? Zeigen sie sonstige interessante Areale? Und vermuten wir einen laufenden Sprachwandel, den wir anhand der unterschiedlichen Sprachverwendung älterer und jüngerer Sprecher*innen indirekt feststellen können (z. B. die mehrfache Verneinung in Ich habe nie niemandem nichts Böses getan)?
In unseren Karten zeigen wir die Mehrheitskategorie der Erstantworten der Dialektsprechenden verschiedener Personen- und Altersgruppen auf eine Frage in unserem Fragebuch. Wenn wir z. B. ein Wort und deren Aussprache oder die Wortwahl in eine farbliche Kategorie einteilen, dann kartieren wir damit auch das Verbreitungsgebiet einer Variante für dasselbe Phänomen.
Wir sprechen hier von sogenannten „Isoglossen“-Grenzen (also Grenzen der ‚gleichen Sprache‘) – also einer Linie die das ungefähre Verbreitungsgebiet der verschiedenen Varianten abdeckt. Diese sind aber von Phänomen zu Phänomen unterschiedlich – wie man beim Vergleichen der Dialektkarten schnell merken wird. Die Sprache der Gemeinschaften ist schließlich nicht fest oder abgeschlossen. Sie ist so flexibel und mobil wie Ihre Sprechendengemeinschaft und die Personen darin selbst.
Nach der Festlegung der Orte wurden die jeweiligen Sprecher*innen so ausgewählt, dass alle zumindest in derselben politischen Gemeinde (und nicht etwa in einer kleineren Einheit wie Ortschaft oder Weiler) wohnten. Zur Darstellung dieser Gemeinden als Punkte auf unseren Karten wurde ihr Bevölkerungsschwerpunkt nach den Daten der Statistik Austria (Stand 2025) herangezogen, also jener Punkt, von dem aus die durchschnittliche Entfernung zu allen Einwohner*innen einer Gemeinde am geringsten ist. Die einzige Ausnahme stellt das Dorf Dornauberg-Ginzling im hinteren Zillertal da, das sich die Gemeinden Finkenberg und Mayrhofen teilen. Hier haben wir als Mittelpunkt das ungefähre Ortszentrum gewählt.
Grundsätzlich hat sich das Projekt zum Ziel gesetzt, ein möglichst großes Ortsnetz über die gesamte Landschaft Österreichs abzudecken.
Die Hindernisse, denen man dann allerdings begegnet, wenn man Österreich aus der Vogelperspektive betrachtet, sind beispielsweise die altbekannten Berge (Gebirge und Täler) und Ströme (Flüsse und Seen), in denen generell weniger Personen leben oder Ortschaften bestehen und wo keiner ist, da gibt es auch keine Sprache und keinen Dialekt. Deswegen sind diese Stellen eher „leer“ geblieben und uns konnte teilweise nur ein einziger Ortspunkt Auskunft zum Dialekt der Region geben (vgl. z. B. Murau als einziger Informationspunkt für die westliche Obersteiermark) – wir haben diese Region etwas enttäuscht aber trotzallem liebevoll projektintern das „steirische Bermudadreieeck“ getauft.
Die eigentliche „Regioneneinteilung“ besteht also auf der einen Seite aus bekannten Einordnungen, in denen markante Unterschiede zwischen den Regionen bereits festgestellt wurden: z. B. der Unterschied zwischen den Varietäten des Süd- und Mittelbairischen sowie dem West- und Ostmittelbairischen. Dafür bedanken wir uns auch beim Wörterbuch der bairischen Mundarten in Österreich, das uns eine erste Einteilung aufgrund ihrer Datenbasis bereitgestellt hat. Auch die bekannten Grenzen zwischen Bodenseealemannisch sowie Hoch- und Höchstalemannisch in Vorarlberg wurde uns durch die Kolleg*innen mit alemannischer Expertise erleichtert (ein Dank ergeht an Oliver Schallert).
Allerdings mussten wir auf der anderen Seite darauf achten, welche Orte wir für unsere Dialekterhebung tatsächlich gewinnen konnten und haben unsere Regioneneinteilung an diese angepasst. So finden sich beispielsweise im vergleichsweise kleinen Vorarlberg oder Burgenland jeweils drei Regionenflächen, da die Ergebnisse unserer Auswertungen stärkere Unterschiede für einzelne abgefragten Sätze und Wörter belegten. Hingegen folgten wir für Ober- und Niederösterreich sowie Salzburg den gemeinhin bekannten Grenzen wie „-viertel“ (z. B. Waldviertel, Mühlviertel) oder dem „-gau“ (z. B. Tennengau, Pongau).

Daraus ist somit unsere Karte mit 33 Regionen entstanden, die je nach Kategorienzuweisung der Antworten als eingefärbte Einblendungen für die jeweiligen Altersgruppen bereitsteht.
Dadurch, dass unser Personeninterview mit den Dialektsprechenden von einem Fragebuch geleitet wurde, hat jede Tonaufnahme den ziemlich gleichen Aufbau. Das haben wir uns für das Schneiden der Audiodateien zu Nutze gemacht und haben des Fragebuch samt seiner üblichen Abfolge unserer Fragen in ein Schnittbearbeitungsprogramm eingespeist (Sound Tool Extended; STx). Das Programm hat uns visuell Blöcke, die eine Zeitspanne darstellen, über die Wellenform des Lautstärkepegels gelegt, welche wir nur noch an die richtige Stelle verschieben mussten. Generell konnten wir uns daran orientieren, dass der Fragesteller weniger nah am Mikrophon sitzen würde und dementsprechend „leiser“ also auch kleiner zu sehen sein würde. Der Dialektsprechende im Fokus stellt hingegegen die größeren Ausschläge dar. Trotzem mussten wir für jede Frage und jede Aufnahme manuell hineinhören und markieren, wo nun die tatsächliche Antwort auf den richtigen Frageblock folgt.
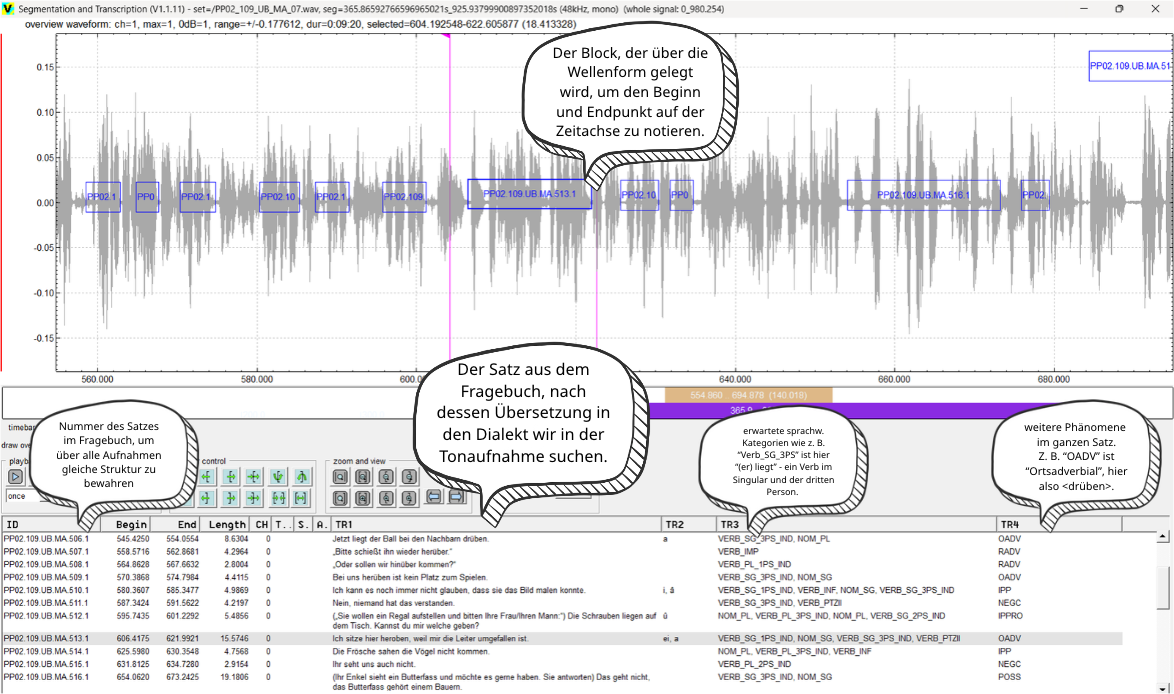
Bei knapp 300 Audioaufnahmen und etwa 900 einzelnen Aufgaben (darunter auch Unterpunkte, wie z. B. Einzahl, Mehrzahl und Verkleinerungsformen) nahmen die reinen „Schnitte“ bzw. Zeitsegmenteinteilungen die Arbeitskraft mehrerer Personen über Jahre hinweg in Anspruch. Aber damit nicht genug. Da wir für den Atlas natürlich auch auf den Höreindruck achten wollten, werden die Audiodateien nachbearbeitet – also wird etwaiges Rauschen entfernt und ein „direkterer“ Schnitt erstellt, auf denen der Fragesteller z. B. nicht zu hören ist.
Ein paar Hard-Facts dazu:
Anzahl Personen: 294 Dialektsprecher*innen
Insgesamt konnten wir 294 Personen für die Erstellung unseres Sprachatlanten gewinnen. Orte, die in Phase I des Projektes abgedeckt sind, sind mit bis zu vier Personen pro Ort vorhanden, während die Orte aus Phase II mit bis zu zwei Personen repräsentiert werden.
Einige wenige Aufnahmen mussten wir im Nachhinein ausschließen, wenn sich herausstellte, dass die Audioaufnahme nicht in genügend guter Qualität abgespeichert wurde, oder die Personen vereinzelt doch nicht unseren Kriterien entsprachen (z. B. doch zu lange in anderen Orten gearbeitet hatten).
Anzahl Ortspunkte: 107
Burgenland: 5 | Kärnten: 7 | Niederösterreich: 19 | Oberösterreich: 15 | Salzburg: 14 | Steiermark: 16 | Tirol: 23 | Vorarlberg: 8 |
Anzahl an Aufgaben pro Interviewaufnahme: ca. 900 pro Person
Jede unserer Dialektsprechenden übersetzte uns knapp 900 Wörter oder Sätze in ihren Dialekt: Darunter finden sich sowohl direkte Übersetzungsaufgaben von der Standardsprache in den eigenen Dialekt, Bildbenennungsaufgaben, Ergänzungsaufgaben (z. B. „Wenn der Zaun nicht hoch ist, dann ist er …. ?“ oder Erklärungsfragen (Was meint ihr, wenn ihr „Nudel“ sagt?“ – Etwas Gebackenes oder etwas zum Kochen in Wasser?). Zu den 900 Aufgabenstellungen zählen allerdings auch z. B. Abfragen in der Wortbeugung wie etwa <gehen>, <gegangen>, <ich gehe>, <du gehst> und so weiter und so fort. Wir können leider nicht alles darstellen und mussten uns auf einige wenige Phänomene beschränken.
Speicherplatz: 250gb für alle Audiodateien (138gb aus Phase I und 112gb aus Phase II)
Das entspricht ungefähr einer Speichergröße von 15 – 20 Ultra HD Filmen, mehr als 50.000 Fotos oder Songs (also knapp 39 Studioalben).
Audiolänge: 558 Stunden, 48 Minuten, 18 Sekunden
Phase I : 308 Stunden, 59 Minuten, 35 Sekunden & Phase II: 249 Stunden, 48 Minuten, 43 Sekunden
D.h. man würde ganze 23 Tage, 6 Stunden, 48 Minuten und 18 Sekunden lang durchgehend unsere Interviews anhören können.Arbeitszeit für das Schneiden: ~ 1.350 Stunden = 33 Arbeitswochen bei 8h für eine 5-Tage-Woche
Damit ist nur die reine „Schneidearbeit“ gemeint, sodass aus einem Interview viele kleine Audiodateien entstehen, was sich auf etwa vier bis fünf Stunden pro Aufnahme beläuft. Die gesamte Planung des Fragebuchs, das Finden, Kontaktieren von und die Terminkoordination mit den Dialektsprechenden sowie die Anreise, das Abhalten des eigentlichen Interviews sowie Nachbearbeitungen der Audiodateien oder die Auswertung der Phänomene ist hier noch gar nicht eingerechnet.
Weitere fünf bis sechs Stunden nimmt die Auswertung eines einzelnen Phänomens für alle 294 Dialektsprechenden in Anspruch – nun da wir bereits vorgeschnittene Audiodateien haben. Das sind weitere 300 Arbeitsstunden für die ungefähr 60 Karten, die wir hier erstellen wollen. Und das ganz ohne Informationstext – nur für die Einteilung in „Variante A“, „Variante B“, „Variante C“ und so weiter und so fort ….